
امروزه هوش مصنوعی از یک فناوری آزمایشی به یک الزام راهبردی برای ارزشآفرینی و حفظ رقابتپذیری سازمانها تبدیل شده است، در حالی که علم داده همچنان نقش توانمندسازی حیاتی را در تبدیل اطلاعات خام به دانش کاربردی ایفا میکند. با این حال، چالشهایی نظیر شکاف مهارتهای فنی، فرآیندهای زمانبر دستی و پیچیدگیهای حکمرانی در اکوسیستمهای متنباز مانند پایتون و آر، مانع از مقیاسپذیری کامل این قابلیتها شدهاند. این گزارش به تبیین «چرخه حیات علم داده مبتنی بر هوش مصنوعی» میپردازد؛ رویکردی نوین که با تعبیه خودکارسازی هوشمند در مراحل چهارگانه این چرخه—شامل آمادهسازی مدل، ساخت، عملیاتیسازی و حکمرانی—علاوه بر ارتقای توانمندیهای انسانی و همگانیسازی تحلیلهای پیشرفته، نقشه راهی پنجگانه و راهبردی برای رهبران فناوری اطلاعات جهت تسریع پذیرش مسئولانه و اثربخش هوش مصنوعی ارائه میدهد.
نویسندگان: دونالد فارمر و دکتر فرن هالپر
فهرست
ظهور هوش مصنوعی و پیدایش ابزارهای متنباز
نقش راهبردی هوش مصنوعی و علم داده
هوش مصنوعی دیگر یک فناوری آزمایشی نیست، بلکه به یک الزام راهبردی برای تقریباً تمامی سازمانها تبدیل شده و نحوه عملکرد، رقابت و ارزشآفرینی آنها را دگرگون کرده است. برای سازمانها و بنگاههای اقتصادی، هوش مصنوعی شخصیسازی بیسابقهای در تجربیات مشتریان فراهم میسازد، تصمیمگیری را از طریق تحلیلهای پیشبینانه تحول میبخشد و بهرهوری عملیاتی را در تمامی بخشهای کسبوکار ارتقا میدهد. از بهینهسازی زنجیره تامین گرفته تا کشف تقلب، برنامههای کاربردی مبتنی بر هوش مصنوعی در حال ایجاد مزیتهای رقابتی ملموس برای پیشگامان این حوزه هستند.
اگرچه هیجان موجود عمدتاً معطوف به خود هوش مصنوعی است، اما علم داده همچنان به عنوان توانمندسازی حیاتی شناخته میشود؛ حوزهای که اطلاعات خام را به دانش کاربردی و راهبردی تبدیل میکند. با این حال، علم دادهِ اثرگذار مستلزم تخصص بالایی در آمار، برنامهنویسی، دانش گسترده در حوزه مدنظر (Domain Knowledge) و بینش کسبوکار است. این الزام چندرشتهای، همزمان فرصتها و چالشهای متعددی را پیش روی رهبران فناوری اطلاعات قرار میدهد.
پژوهشهای مؤسسه TDWI نشاندهنده یک فضای دوقطبی است. حدود نصف سازمانهای مورد بررسی به طور فعال در حال توسعه مدلهای هوش مصنوعی و ایجاد روشهای بالغ در علم داده هستند، در حالی که نیم دیگر در تلاش برای دستیابی به این قابلیتها بوده اما با موانع اجرایی مواجهاند. این شکاف عمدتاً از چالش «شکاف مهارتها» ناشی میشود؛ یعنی کمبود متخصصانی که بتوانند پیچیدگیهای فنی را به ارزشآفرینی در کسبوکار پیوند زنند.
مانع تخصص فنی به ویژه از آن جهت حاد است که علم داده نیازمند تسلط بر زبانهای برنامهنویسی، روشهای آماری، الگوریتمهای یادگیری ماشین و اقدامات مهندسی داده است. سازمانها در جذب و نگهداری تیمهای دارای این مهارتها با چالش روبرو هستند که این امر ظرفیت آنها را در پذیرش هوش مصنوعی محدود میسازد. بنابراین، این چالش صرفاً یک مسئله فنی نیست، بلکه یک مسئله سازمانی است.
مزایا و موانع ابزارهای متنباز
ابزارهای متنباز به ستون فقرات علم داده مدرن تبدیل شدهاند و زبانهای پایتون و آر (R) به دلیل انعطافپذیری، مقرونبهصرفه بودن و اکوسیستمهای غنی، بر این عرصه تسلط دارند. این پلتفرمها دسترسی به الگوریتمها و روششناسیهای پیشرفته را فراهم میکنند که غالباً ماهها یا سالها جلوتر از جایگزینهای تجاری هستند.
ابزارهای متنباز نقطهورودی کمهزینه برای تحلیلهای پیشرفته فراهم میکنند و کدها به صورت رایگان همراه با پشتیبانی یک جامعه کاربری فعال ارائه میشوند.
متنباز مجموعه منحصربهفردی از مزایای کلیدی را ارائه میدهد که آن را هم برای سازمانها و هم برای توسعهدهندگان جذاب میسازد. این ابزارها نقطهورودی کمهزینه برای تحلیلهای پیشرفته فراهم میکنند و کدهای کاملاً رایگان آنها توسط جامعهای پویا پشتیبانی میشود. کتابخانههای بنیادی که انقلاب امروز هوش مصنوعی را تغذیه میکنند (مانند scikit-learn برای یادگیری ماشین، TensorFlow و PyTorch برای یادگیری عمیق، و مجموعه tidyverse در زبان R برای دستکاری دادهها) نمادی از سرعت نوآوری در ابزارهای متنباز هستند. علاوه بر این، ابزارهای متنباز وابستگی به فروشنده (Vendor Lock-in) را از بین میبرند و به کاربران انعطافپذیری و استقلال لازم را میدهند تا بدون وابستگی به تامینکنندگان نرمافزارهای انحصاری، ابزارها و بهروزرسانیهای خود را مدیریت کنند.
با این حال، این مزیتها با چالشهایی نیز همراه هستند. ابزارهای متنباز اغلب نیازمند تخصص فنی بالایی هستند. برخلاف پلتفرمهای تجاری که ساختارهای پشتیبانی یکپارچه دارند، راهکارهای متنباز نیازمند دانش داخلی سازمان برای عیبیابی، نگهداری و بهینهسازی هستند. علاوه بر این، الزامات حکمرانی سازمانی (مانند ردپای حسابرسی، کنترلهای امنیتی، و مستندات انطباق) اغلب در محیطهای متنباز نیازمند پیادهسازی سفارشی هستند.
تقابل میان پتانسیل نوآوری ابزارهای متنباز و نیازهای عملیاتی سازمانی، یک دوگانه راهبردی برای رهبران فناوری اطلاعات ایجاد میکند: آیا باید برای حداکثر انعطافپذیری، پیچیدگی را پذیرفت یا برای سادگی عملیاتی، محدودیتها را تن داد؟
چگونه ابزارهای هوش مصنوعی میتوانند کمک کنند
پلتفرمهای نوظهور علم دادهِ مجهز به هوش مصنوعی وعده میدهند که این دوگانه را با تعبیه مستقیم دستیارهای هوشمند در گردشهای کاری متنباز حل کنند. برخی از این قابلیتها هماکنون در ابزارهای تجاری یافت میشوند. این راهکارها میتوانند به حفظ انعطافپذیری و مزایای هزینهای پایتون و آر کمک کرده و در عین حال، موانع فنی را کاهش داده و به بهرهوری سرعت بخشند. ابزارهای مجهز به هوش مصنوعی میتوانند در سراسر چرخه حیات علم داده در حوزههای متعددی از جمله آمادهسازی دادهها، مهندسی ویژگی، تولید و تکمیل کد، تولید بینش، یکپارچهسازی گردش کار، و پایش و نگهداری کمککننده باشند.
برای نمونه، ابزارهای مبتنی بر هوش مصنوعی میتوانند به طور خودکار مجموعه دادهها را پروفایلبندی کنند، مسائل کیفی را شناسایی نمایند، ناهنجاریها را کشف کرده و تغییرات مناسب را پیشنهاد دهند. آنها میتوانند از یادگیری ماشین برای پیشنهاد متغیرهای مرتبط و تبدیلها در مهندسی ویژگی استفاده کنند. این ابزارها میتوانند کمکهای لحظهای برای اسکریپتنویسی، اشکالزدایی و بهینهسازی ارائه دهند. همچنین امکاناتی برای کشف انحراف، پایش عملکرد و سیستمهای هشداردهی فراهم میکنند تا اطمینان حاصل شود که مدلها بدون نیاز به نظارت دستی مداوم، در طول زمان اثربخش باقی میمانند.
وعده نهایی پس از این قابلیتها، همگانیسازی توانمندیهای علم داده در عین حفظ دقت حرفهای و امکان مشارکت گستردهتر سازمانی در ابتکارات هوش مصنوعی بدون آسیب به استانداردهای کیفیت یا حکمرانی است. برای رهبران فناوری اطلاعات، این امر نمایانگر فرصتی برای شتاببخشی به پذیرش هوش مصنوعی است، در حالی که از سرمایهگذاریهای موجود در ابزارهای متنباز بهره برده و محدودیتهای مهارت را از طریق اتوماسیون هوشمند برطرف میسازند.
توجیه اقتصادی علم داده مبتنی بر هوش مصنوعی
همگرایی هوش مصنوعی با گردشهای کاری سنتی علم داده، چیزی بیش از یک تکامل فناوری است؛ این تغییر نشاندهنده یک تحول بنیادین در نحوه مقیاسپذیری قابلیتهای تحلیلی سازمانها و در عین حال مدیریت پیچیدگی و ریسک است. ابزارهای مجهز به هوش مصنوعی جایگزین تخصص انسانی نمیشوند؛ بلکه با خودکارسازی کارهای تکراری، پیشنهاد بهینهسازیها و ارائه راهنماییهای هوشمند در سراسر فرآیند تحلیلی، آن را تقویت میکنند. این پلتفرمها مزایای انعطافپذیری و نوآوری محیطهای متنباز را حفظ کرده و در عین حال، اتوماسیون هوشمندی را معرفی میکنند که موانع فنی را کاهش داده، چرخه توسعه را سریعتر ساخته و کیفیت خروجی را ارتقا میدهد.
برای رهبران فناوری اطلاعات، این موضوع فرصتی است تا قابلیتهای تحلیل پیشرفته را در سراسر سازمان همگانی سازند، در حالی که استانداردهای حکمرانی را حفظ کرده و از سرمایهگذاریهای فناوری موجود حداکثر استفاده را ببرند. توجیه اقتصادی این موضوع فراتر از صرفهجویی در هزینهها است و چابکی راهبردی، کاهش ریسک، و مزیت رقابتی از طریق دسترسی سریعتر به بینشها و مشارکت گستردهتر سازمانی در تصمیمگیریهای دادهمحور را در بر میگیرد.
تبیین چرخه حیات علم داده
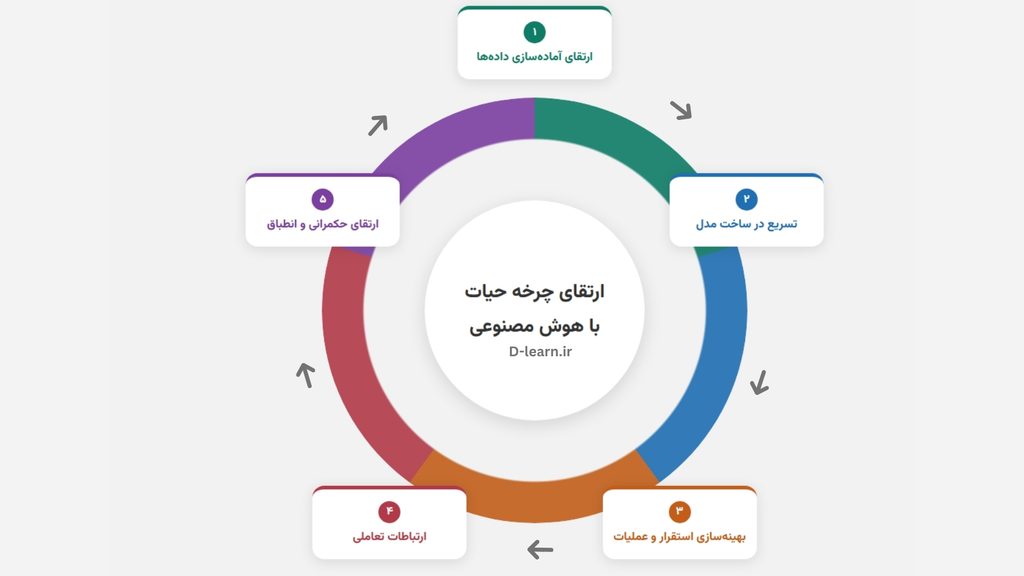
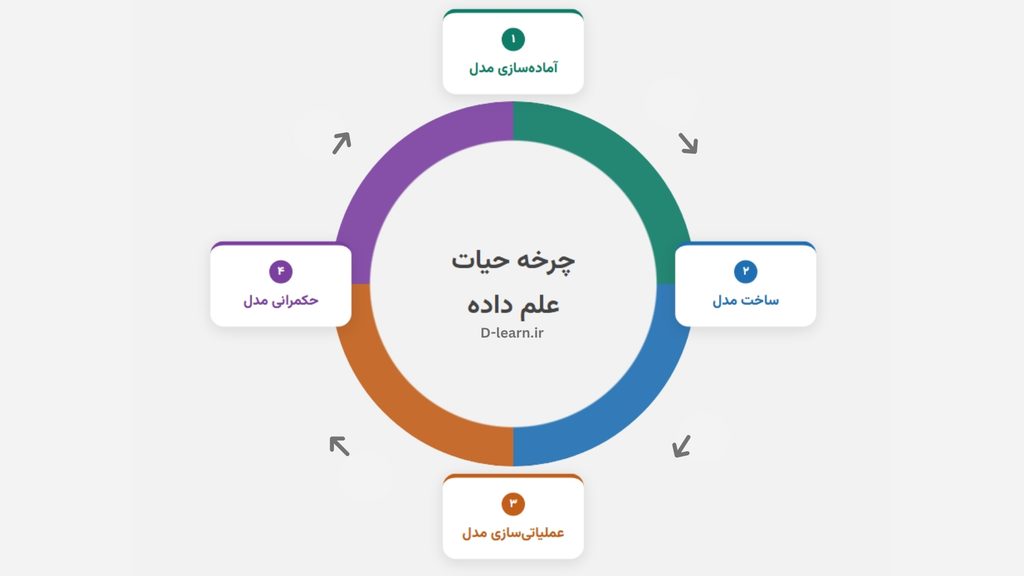
درک ارزش اقتصادی ابزارهای مجهز به هوش مصنوعی مستلزم شناخت پیچیدگی و وابستگیهای متقابل در چرخه حیات علم داده است. این چرخه حیات، نشاندهنده رویکردی نظاممند برای تبدیل پرسشهای کسبوکار به بینشهای کاربردی از طریق تحلیل دادهها و مدلسازی پیشبینانه است. این چرخه حیات چهار مؤلفه اصلی دارد: آمادهسازی مدل، ساخت مدل، عملیاتیسازی مدل، و حکمرانی مدل. هر مرحله شامل چالشها، نیازمندیهای مهارتی و فرصتهای منحصربهفردی برای اتوماسیون هوشمند است.
آمادهسازی مدل
این مرحله بنیادی شامل تعریف مسئله، شناسایی دادهها و فعالیتهای اولیه آمادهسازی است. نخست، تعریف مسئله و همراستایی با کسبوکار، فرآیند ترجمه اهداف کسبوکار به پرسشهای قابل تحلیل از نظر ریاضی و آماری است که نیازمند همزمان تخصص دامنه و درک فنی است. سازمانها اغلب در این مرحله دچار مشکل میشوند و پروژهها به دلیل انتظارات ناهمراستا یا اهداف تحلیلی نامشخص با شکست مواجه میگردند.
در ادامه، شناسایی، فراخوانی و ارزیابی اولیه دادهها قرار دارد که شامل کشف و ارزیابی منابع دادهای مرتبط است. این مرحله اغلب مسائل مربوط به کیفیت داده، محدودیتهای دسترسی و چالشهای یکپارچهسازی را نمایان میسازد که میتواند پروژهها را پیش از شروع تحلیل متوقف کند. رهبران فناوری اطلاعات این بخش را به عنوان گلوگاه حیاتی میشناسند که در آن پیچیدگی فنی با الزامات کسبوکار تلاقی پیدا میکند.
پس از آن، آمادهسازی دادهها، پاکسازی و ساخت خط لوله داده (Data Pipeline) قرار دارد که زمانبرترین مرحله بوده و معمولاً ۶۰ تا ۸۰ درصد از کل تلاش پروژه را به خود اختصاص میدهد. دانشمندان داده باید تناقضات را شناسایی کنند، مقادیر مفقود را مدیریت نمایند، فرمتها را استانداردسازی کنند و خطوط لوله دادهای قابل اعتمادی بسازند. این کار مستلزم تخصص فنی بالا است در حالی که رضایت فکری کمی به همراه دارد؛ ترکیبی که به چالشهای نگهداری استعدادها دامن میزند.
سپس دانشمندان داده به تحلیل اکتشافی دادهها (Exploratory Data Analysis – EDA) و فرضیهسازی میپردازند که شامل تحلیل آماری برای درک ویژگیهای داده، شناسایی الگوها و تدوین فرضیههای قابل آزمون است. این مرحله نیازمند تخصص آماری و محاسباتی همراه با شهود کسبوکار برای هدایت مسیرهای تحلیلی معنادار است.
ساخت مدل
در مرحله توسعه مدل، دانشمند داده، دادههای آمادهشده را گرفته و مدلهای پیشبینانه میسازد. این مرحله غالباً با مهندسی ویژگی (Feature Engineering) و انتخاب ویژگیها آغاز میشود؛ فرآیند خلق و انتخاب متغیرهایی که مسئله کسبوکار را به بهترین شکل نمایندگی میکنند. این ویژگیها میتوانند به سادگی یک نسبت یا به پیچیدگی یک امتیاز وفاداری مشتری باشند. این فرآیند دانش آماری، تخصص دامنه و خلاقیت را ترکیب میکند و اغلب مرز میان مدلهای موفق و ناموفق را تعیین مینماید.
سپس، دانشمند داده الگوریتمها را انتخاب کرده و معماری مدل را تعیین میکند که مستلزم درک نقاط قوت و محدودیتهای رویکردهای مختلف تحلیلی است. دانشمندان داده باید بین پیچیدگی مدل، الزامات تفسیرپذیری، محدودیتهای محاسباتی و اهداف کسبوکار تعادل برقرار کنند. گسترش روزافزون الگوریتمها و روشهای موجود، این انتخاب را چالشبرانگیزتر کرده است.
پس از آن، دانشمند داده به آموزش، اعتبارسنجی و آزمون مدل میپردازد. این مرحله شامل تکنیکهای آماری پیشرفته است تا اطمینان حاصل شود مدلها فراتر از دادههای آموزشی تعمیم مییابند و دچار بیشبرازش نمیشوند؛ بیشبرازش علت شایعی برای شکست مدلها در محیط عملیاتی است. دانشمند داده ممکن است مدل را از طریق تنظیم نظاممند پارامترها بهطور دقیق تنظیم کند (Fine-tuning). این فرآیندِ متمرکز بر محاسبات، نیازمند دانش آماری و تجربه عملی برای دستیابی کارآمد به نتایج بهینه است.
سپس مدل ثبت شده و تحت کنترل نسخه قرار میگیرد تا بازتولیدپذیری تضمین شده و توسعه همکاریمحور میسر گردد. این جنبه که غالباً مغفول میماند، در محیطهای سازمانی که الزامات انطباق با مقررات و نیازهای حسابرسی مستلزم مستندسازی جامع هستند، حیاتی میشود.
عملیاتیسازی
مرحله استقرار، توسعه تحلیلی را به برنامههای کاربردی کسبوکار پیوند میدهد. استقرار مدل در محیطهای عملیاتی مستلزم یکپارچهسازی فنی با سیستمهای موجود و در عین حال حفظ استانداردهای عملکرد و قابلیت اطمینان است. این مرحله اغلب شکافهای میان محیط توسعه و محیط عملیات را آشکار میسازد که میتواند اثربخشی مدل را به مخاطره اندازد. این مرحله معمولاً نیازمند یکپارچهسازی با برنامهها و سیستمهای کسبوکار است. چنین یکپارچهسازی مستلزم درک خروجیهای تحلیلی و گردشهای کاری کسبوکار است؛ ترکیبی از مهارتها که گلوگاههای اجرایی ایجاد میکند.
مدل همچنین باید در محیط زنده اعتبارسنجی شده و پایش شود تا اثربخشی آن در طول زمان حفظ گردد. مدلهای زیر بار عملیاتی با انحراف دادهها (Data Drift)، انحراف مفهوم (Concept Drift) و افت عملکرد مواجه میشوند که نیازمند پایش و مداخله مداوم است. مدل پس از قرارگیری در محیط عملیاتی، نیازمند نگهداری است تا ارزش بلندمدت خود را از طریق دورههای بروزرسانی منظم، بهینهسازی عملکرد و تطبیق با تغییر نیازهای کسبوکار حفظ کند.
حکمرانی
مدلها همچنین نیازمند حکمرانی هستند. این نوع از حکمرانی با حکمرانی دادهها متفاوت است و تحقیقات TDWI نشان میدهد که سازمانها تازه در ابتدای این مسیر قرار دارند. با این حال، الزامات شفافیت مدل، قابلیت توضیحپذیری و اعتماد، با نظارتهای قانونی و تقاضای کسبوکارها برای سیستمهای هوش مصنوعی قابل تفسیر (مانند قانون هوش مصنوعی اتحادیه اروپا، DORA و غیره) تشدید شده است. این مسئله مستلزم مستندسازی، ردپای حسابرسی و کنترلهایی است که کل چرخه حیات مدل را پوشش دهد. همچنین شامل مدیریت ریسک و کشف سوگیری جهت شناسایی پیامدهای منفی احتمالی و تضمین پیامدهای عادلانه مدل در میان جمعیتهای مختلف خواهد بود.
پیچیدگی این چرخه حیات، فرصتهای متعددی را برای ابزارهای مجهز به هوش مصنوعی ایجاد میکند تا ارزشآفرینی کنند و در عین حال روشن میسازد چرا رویکردهای سنتی در مقیاسپذیری موثر در سطح سازمان با چالش مواجهاند.
ارتقای چرخه حیات با هوش مصنوعی
ابزارهای مجهز به هوش مصنوعی، توانمندیهای انسانی را تقویت میکنند و اجرای سریعتر را در عین حفظ کیفیت و کنترل امکانپذیر میسازند.
ابزارهای مجهز به هوش مصنوعی با خودکارسازی هوشمند کارهای تکراری، ارائه پیشنهادات در سطح متخصص و کاهش موانع فنی که مانع از مشارکت گستردهتر سازمانی در علم داده میشوند، ارزشآفرینی میکنند. این ابزارها به جای جایگزینی قضاوت انسانی، توانمندیهای انسان را در هر مرحله از چرخه حیات تقویت کرده و اجرای سریعتر را همراه با حفظ کیفیت و کنترل میسر میسازند. پژوهشهای TDWI نشان میدهد که این ابزارهای خودکار مجهز به هوش مصنوعی در حال تبدیل شدن به امری حیاتی برای سازمانها هستند. برای نمونه، در نظرسنجی اخیر TDWI، اکثریت قاطع پاسخدهندگان (۷۸٪) با این گزاره موافق بودند: «استفاده از ابزارهای “هوشمند” موجود در بازار که از هوش مصنوعی/یادگیری ماشین برای مدیریت دادهها جهت پروفایلبندی، تبدیل و پردازش دادهها استفاده میکنند، حائز اهمیت است.»
این ابزارها در چهار حوزه چرخه حیات علم داده که پیشتر توصیف شد، کمک میکنند: آمادهسازی دادهها، ساخت مدل، استقرار مدل و حکمرانی. علاوه بر این، این ابزارها میتوانند به ارتباطات تعاملی کمک نمایند. این مزایا در بخش بعدی تشریح شدهاند.
ارتقای آمادهسازی دادهها
- پروفایلبندی خودکار دادهها: فرآیند زمانبر شناخت مجموعه دادههای جدید را دگرگون میسازد. ابزارهای هوش مصنوعی ساختار دادهها، توزیعهای آماری، روابط بین متغیرها و مسائل کیفی را تحلیل کرده و گزارشهای جامعی تولید میکنند که در غیر این صورت نیازمند ساعتها کاوش دستی بود. این سیستمها مقادیر مفقود، دادههای پرت، فرمتهای ناهمگون و مشکلات احتمالی کیفیت داده را شناسایی کرده و خلاصهها و تجسمهای آماری ارائه میدهند که ارزیابی اولیه دادهها را سرعت میبخشد.
- کاوش هوشمند دادهها: رابطهای زبان طبیعی را معرفی میکند که تحلیلگران کسبوکار و متخصصان دامنه را قادر میسازد مستقیماً در کشف دادهها مشارکت کنند. کاربران به جای نیاز به تخصص SQL یا برنامهنویسی، میتوانند درخواستهایی مانند «روند فروش را بر اساس منطقه به من نشان بده» یا «الگوهای غیرعادی رفتار مشتری را شناسایی کن» مطرح کرده و تحلیلهای مرتبط را دریافت نمایند. این قابلیت دسترسی به دادهها را همگانی میسازد در حالی که دقت تحلیلی را از طریق تفسیر و اجرای پرسوجوها مبتنی بر هوش مصنوعی حفظ میکند.
- پیشنهادات تبدیل هوشمند: از یادگیری ماشین برای پیشنهاد مراحل مناسب پاکسازی و آمادهسازی دادهها بر اساس الگوهای شناساییشده، انواع دادهها و مسائل کیفی بهره میبرد. این سیستمها از الگوهای موفق تبدیل در مجموعهدادههای مشابه یاد میگیرند و رویکردهای استانداردسازی، استراتژیهای مدیریت مقادیر مفقود و تبدیل انواع دادهها را پیشنهاد میکنند تا اثربخشی تحلیلهای بعدی بهینه شود.
- قابلیتهای کشف ناهنجاری: به طور خودکار دادههای پرت، تناقضات و الگوهای غیرعادی را که ممکن است نشاندهنده مشکلات کیفیت داده یا پدیدههای جالب کسبوکار باشند، شناسایی میکند. این اتوماسیون مواردی را کشف میکند که بررسی دستی ممکن است از آنها غفلت کند و در عین حال بینشهای بالقوهای را که نیازمند بررسی بیشتر هستند، مشخص میسازد.
سرعت بخشیدن در ساخت مدل
- یکپارچهسازی یادگیری ماشین خودکار (AutoML): احتمالاً بنیادیترین ارتقا محسوب میشود که فرآیندهای انتخاب الگوریتم، مهندسی ویژگی و بهینهسازی ابرپارامترها را که معمولاً نیازمند تخصص و آزمونواندیشه فراوان هستند، خودکار میکند. این سیستمها رویکردهای مختلف مدلسازی را ارزیابی کرده، ترکیبات ویژگی را به طور خودکار ساخته و تست میکنند و پارامترهای مدل را بهینهسازی مینمایند تا به عملکرد مطلوب برای اهداف مشخص کسبوکار دست یابند.
یادگیری ماشین خودکار (AutoML) تحلیلگران کمتجربهتر را قادر میسازد تا مدلهای پیچیدهای بسازند، در حالی که دانشمندان داده باسابقه را آزاد میگذارد تا بر حل مسائل پیچیده و استراتژی کسبوکار تمرکز کنند.
- دستیار کدنویسی هوشمند: پشتیبانی آنی برای توسعه پایتون و آر را از طریق پیشنهادات آگاه از زمینه، تکمیل خودکار کد و کشف خطا ارائه میدهد. این ابزارها گردشهای کاری تحلیلی را درک کرده، توابع مرتبط را پیشنهاد میدهند، باگهای احتمالی را شناسایی میکنند و توضیحاتی را برای بخشهای پیچیده کد ارائه میدهند. این قابلیت علاوه بر تسریع توسعه، به عنوان یک پلتفرم یادگیری برای تحلیلگرانی عمل میکند که در حال ارتقای مهارتهای فنی خود هستند.
- پیشنهادات معماری مدل: ویژگیهای مسئله، خواص دادهها و الزامات عملکرد را تحلیل میکند تا رویکردهای بهینه مدلسازی را پیشنهاد دهد. به جای آزمونواندیشه دستی با الگوریتمهای مختلف، این سیستمها نقاط شروع هوشمندی را بر اساس پروژههای موفق مشابه و بهترین روشهای نظری ارائه میدهند.
- ابزارهای نمونهسازی سریع: با ارائه رویکردهای مبتنی بر قالبهای اولیه با سفارشیسازی هوشمند، موانع را برای تحلیلگرانی که با تکنیکهای مدلسازی پیشرفته آشنایی کمتری دارند، کاهش میدهد. این پلتفرمها دورههای توسعه و تست سریع مدل را میسر میسازند و به سازمانها اجازه میدهند پیش از تخصیص منابع عمده، رویکردهای تحلیلی را ارزیابی کنند.
بهینهسازی استقرار و عملیات
- سیستمهای پایش خودکار: به طور مداوم عملکرد مدل، کیفیت دادهها و تاثیرات کسبوکار را در محیطهای عملیاتی ارزیابی میکنند. این ابزارها انحراف دادهها (تغییر در ویژگیهای دادههای ورودی به مرور زمان)، انحراف مفهوم (تغییر در روابط بنیادی میان متغیرها) و افت عملکرد را که میتوانند اثربخشی مدل را به مخاطره اندازند، کشف میکنند. هشدارهای خودکار، مداخله بهموقع را در زمان نیاز مدل به توجه یا آموزش مجدد تضمین میکنند.
- زمانبندی هوشمند: منابع محاسباتی و زمان اجرای کارهای تحلیلی را بر اساس بار سیستم، در دسترس بودن دادهها و الزامات کسبوکار بهینهسازی میکند. این اتوماسیون بهرهبرداری کارآمد از منابع را تضمین کرده و توافقنامههای سطح خدمت (SLA) را برای فرآیندهای تحلیلی حیاتی حفظ مینماید.
- قابلیتهای مدیریت نسخه: مدیریت نسخه، مقایسه و بازگشت به نسخههای قبلی مدل را به کمک هوش مصنوعی فراهم میکند. این سیستمها تاریخچه مدل، معیارهای عملکرد و سوابق استقرار را ردیابی میکنند و پاسخ سریع به مسائل عملیاتی را امکانپذیر ساخته و ردپای دقیق حسابرسی را حفظ مینمایند.
ارتباطات تعاملی
- تجسمسازی و تولید زبان طبیعی (NLG): به طور خودکار داشبوردها، گزارشها و ارتباطات با ذینفعان را ایجاد کرده و تحلیلهای فنی را به بینشهای مرتبط با کسبوکار ترجمه میکند. این ابزارها توضیحات متنی از یافتههای تحلیلی تولید میکنند، تجسمهای مناسبی برای مخاطبان مختلف میسازند و استانداردهای گزارشدهی یکپارچهای را در سراسر پروژهها حفظ میکنند. این اتوماسیون شکاف ارتباطی میان تیمهای فنی و ذینفعان کسبوکار را پر کرده و تضمین میکند بینشهای تحلیلی منجر به اقدام در کسبوکار میشوند.
ارتقای حکمرانی و انطباق
- مستندسازی خودکار: مستندات جامع مدل، مدیریت متاداده (Metadata) و مشخصات فنی مورد نیاز برای انطباق با مقررات و انتقال دانش را تولید میکند. این سیستمها فرضیات مدل، منابع داده، منطق تبدیل و ویژگیهای عملکرد را در فرمتهای استاندارد ضبط میکنند که از الزامات حسابرسی و توسعه مشارکتی پشتیبانی میکند.
- ابزارهای کشف سوگیری: به طور خودکار مدلها را از نظر نتایج تبعیضآمیز احتمالی در بخشهای مختلف جمعیت ارزیابی میکنند. این سیستمها سوگیریهای آماری، معیارهای عدالت و تاثیرات متفاوت را تست کرده و استراتژیهایی برای کاهش سوگیری پیشنهاد میدهند. این قابلیت پاسخگوی الزامات قانونی روزافزون بوده و از استقرار اخلاقی هوش مصنوعی پشتیبانی میکند.
- ردیابی اصالت: مستندسازی خودکار اصالت داده و مدل را ارائه میدهد که فرآیندهای تحلیلی را از دادههای منبع تا خروجیهای نهایی ردیابی میکند. این قابلیت از الزامات بازتولیدپذیری، تحلیل تاثیر و مستندات انطباق پشتیبانی کرده و عیبیابی و اشکالزدایی مدل را تسهیل مینماید.
- سیستمهای هشداردهی: پایش هوشمندی را فراهم میکنند که هنگام نیاز مدل به توجه، بروز مسائل انطباق، یا تجاوز از حد آستانه عملکرد، اعلانها را فعال میسازد. این سیستمها هشدارها را بر اساس تاثیر کسبوکار اولویتبندی کرده و بافت مرتبط را برای حل سریع مسئله ارائه میدهند.
اثر تراکمی این ارتقاها میتواند علم داده را از یک حوزه تخصصی و پرهزینه به یک قابلیت سازمانی آسانتر و مقیاسپذیرتر تبدیل کند، در حالی که استانداردهای حرفهای و الزامات حکمرانی حفظ میشوند.
اقدامات کلیدی برای شروع
پیادهسازی موفق علم دادهِ مجهز به هوش مصنوعی نیازمند برنامهریزی نظاممند، انتخاب راهبردی ابزارها و مدیریت تغییرات سازمانی است. پنج اقدام کلیدی زیر، رویکردی ساختاریافته برای رهبران فناوری اطلاعات فراهم میکند تا این تحول را مدیریت کرده و در عین حال ریسک را به حداقل و ارزش کسبوکار را به حداکثر برسانند. این اقدامات برای اجرا به صورت متوالی طراحی شدهاند و هر یک بر پایه اقدام قبلی شکل میگیرد، اگرچه سازمانها میتوانند زمانبندی و تاکید را بر اساس سطح بلوغ و الزامات کسبوکار خود منطبق سازند.
اقدام ۱: ارزیابی بلوغ تیم و توسعه استراتژی یکپارچهسازی
پیادهسازی ابزارهای مجهز به هوش مصنوعی در چرخه حیات علم داده مستلزم ارزیابی قابلیتهای فعلی تیم و تدوین یک طرح راهبردی یکپارچهسازی است.
کار را با انجام یک پایش جامع مهارتها برای ارزیابی سطوح تسلط در زبانهایی مانند پایتون و آر و همچنین تخصص در مدلسازی آماری آغاز کنید. از ابزارهای ارزیابی استاندارد برای نگاشت صلاحیتهای فردی در برابر الزامات پروژه و نیازهای آتی سازمان استفاده کنید. این فرآیند به شناسایی نقاط قوت، شکافها و حوزههای نیازمند توسعه کمک خواهد کرد.
درک میزان آشنایی تیم با هر دو دسته ابزارهای تجاری و متنباز نیز حائز اهمیت است. اعضای تیم را مورد نظرسنجی قرار دهید تا تجربیات و ترجیحات آنها را درباره پلتفرمهای موجود علم داده بسنجید. نرخ بهرهبرداری فعلی از ابزارها را ارزیابی کرده و هرگونه مقاومت در برابر پذیرش فناوریهای جدید را شناسایی کنید.
ترسیم گردشهای کاری موجود برای شناسایی گلوگاهها و ناکارآمدیها ضروری است. فرآیندهای فعلی را از تعریف مسئله تا استقرار مستند کنید و بر تحویلهای دستی و فعالیتهای زمانبر تاکید نمایید. این تحلیل به بخشهای برنامهریزی راهبردیِ یکپارچهسازی هوش مصنوعی جهت میدهد.
اهداف روشنی برای بهکارگیری هوش مصنوعی تعیین کنید و اهداف قابل اندازهگیری مانند کاهش ۳۰ تا ۵۰ درصدی کارهای تکراری وضع نمایید. این اهداف را با ابتکارات گستردهتر تحول دیجیتال همراستا ساخته و معیارهای موفقیت را برای پایش پیشرفت مشخص کنید. معیارها برای موفقیت حیاتی هستند زیرا به نمایش پیشرفت و موفقیتها کمک میکنند. برخی سازمانها پروژههای پایلوت (آزمایشی) را برای نشان دادن دستاوردهای سریع اجرا میکنند و اطمینان حاصل مینمایند که هر مرحله دارای معیارهای ارزیابی روشن و استراتژیهای کاهش ریسک است.
یک توجیه اقتصادی قوی با پیشبینی بازگشت سرمایه (ROI) از طریق صرفهجویی در هزینهها، افزایش بهرهوری و بهبود قابلیتهای تصمیمگیری تدوین کنید. هزینههای پیادهسازی شامل لایسنس، آموزش و مدیریت تغییر را در نظر بگیرید تا نمای مالی جامعی ارائه دهید.
اقدام ۲: اولویتدهی به ابزارهای مجهز به هوش مصنوعی داخلی و نظارت انسانی
یکپارچهسازی موفق هوش مصنوعی در علم داده مستلزم انتخاب ابزارهایی است که توانمندیهای انسانی را ارتقا داده و در عین حال نظارت مناسب را حفظ نمایند. کلید کار در انتخاب پلتفرمهایی است که دستیاری هوشمند ارائه میدهند بدون آنکه تفکر انتقادی و تخصص دامنهای را که تحلیلگران برای مسائل پیچیده به همراه میآورند، تضعیف کنند.
قابلیتهای ضروری مجهز به هوش مصنوعی باید شامل دستیار کدنویسی پیشرفته با تکمیل آگاه از بافت برای محیطهای پایتون و آر، کشف آنی خطا و جستجوی یکپارچه مستندات باشد. رابطهای زبان طبیعی میتوانند با تمایززدایی و همگانیسازی کشف دادهها، ذینفعان کسبوکار را قادر سازند تا پرسشها را مستقیماً به کدهای تحلیلی ترجمه کنند، در حالی که تولید هوشمند بینش از طریق تشخیص الگو، کشف را سرعت بخشیده و تضمین میکند یافتههای مهم مغفول نمیمانند.
کتابخانههای قالب (Template) با سفارشیسازی هدایتشده توسط هوش مصنوعی، پایههایی را برای کار یکدست و باکیفیت فراهم میسازند. قالبهای تخصصی صنعت که مسائل رایج کسبوکار را آدرسدهی میکنند، زمان شروع پروژه را کاهش داده و انتخاب هوشمند بر اساس ویژگیهای داده، رویکردهای متدولوژیک مناسب را تضمین میکند.
با این حال، حفظ اختیارات تصمیمگیری انسانی در اولویت باقی میماند. گردشهای کاری تایید برای استقرار مدل و پیشنهادات راهبردی تضمین میکنند که تخصص انسانی در مرکز فرآیند تحلیلی باقی میماند. پیشنهادات هوش مصنوعی به جای پیادهسازی خودکار، باید نیازمند پذیرش صریح انسانی باشند و مسیرهای تصاعدی مشخصی برای سناریوهای پیچیدهای که از توانمندی هوش مصنوعی فراتر میروند، تعبیه شود.
شفافیت برای حفظ اعتماد و تمهید همکاری اثربخش انسان و هوش مصنوعی ضروری است. انتساب شفاف محتوای تولیدشده توسط هوش مصنوعی در برابر محتوای ایجادشده توسط انسان، همراه با ارائه دلایل پیشنهادات، به کاربران کمک میکند تا دستیاری دریافتی را درک و ارزیابی کنند. ردپای جامع حسابرسی از الزامات انطباق و بهبود مداوم پشتیبانی میکند.
در نهایت، نقاط ارزیابی و اعتبارسنجی در سراسر فرآیندهای خودکار، کنترلهای کیفی اساسی را فراهم میسازند. تست خودکار برای کدهای تولیدشده توسط هوش مصنوعی، اعتبارسنجی منطق کسبوکار در برابر محدودیتهای شناختهشده، و مدیریت استثنائات، قابلیت اطمینان را تضمین کرده و حوزههایی را که مداخله انسانی برای خروجی بهینه ضروری است، برجسته میسازد.
اقدام ۳: تشویق فرهنگ کاوش ایمن و نوآوری
تمهید نوآوری با ابزارهای هوش مصنوعی مستلزم ایجاد محیطهایی است که تیمها بتوانند آزادانه آزمایش کنند و در عین حال کنترلهای امنیتی و حکمرانی مناسب را حفظ نمایند. چالش موجود در ایجاد تعادل میان فرصتهای کاوش با مدیریت ریسک سازمانی و الزامات حفاظت از دادهها نهفته است.
ایجاد محیطهای ایزوله یا سندباکس اختصاصی، پایه و اساس آزمایش ایمن را فراهم میکند. این محیطهای مجزا باید دسترسی کامل به ابزارهای هوش مصنوعی را با دسترسی محدود به دادهها و سیستمها ارائه دهند و آزمایشهای معناداری را بدون تاثیر بر محیط عملیاتی میسر سازند. آمادهسازی خودکار محیط، راهاندازی سریع را برای آزمایشهای جدید فراهم میکند، در حالی که فضاهای مشترک سندباکس، یادگیری مشارکتی و انتقال دانش را در میان تیمها تسهیل مینماید.
استراتژیهای حفاظت از دادهها برای حفظ امنیت در طول آزمایش حیاتی میشوند. ابزارهای ماسکگذاری دادهها که ویژگیهای تحلیلی را حفظ کرده اما از اطلاعات حساس محافظت میکنند، سناریوهای تست واقعی را میسر میسازند. مجموعهدادههای ساختگی که خواص آماری دادههای عملیاتی را حفظ میکنند، فرصتهای آزمایش بیشتری فراهم میآورند، در حالی که پروتکلهای شفاف برای انتقال دادهها بین محیطها تضمین میکنند کنترلهای حکمرانی مناسب در جای خود باقی میمانند.
کاهش اصطکاک و در عین حال حفظ کنترل مستلزم پیادهسازی رابطهای کاربرپسندی است که دسترسی به دادهها را همگانی میسازد. ابزارهای پرسوجوی زبان طبیعی که پرسشهای کسبوکار را به پرسوجوهای پایگاه داده ترجمه میکنند، مشارکت گستردهتر سازمانی را در فعالیتهای تحلیلی امکانپذیر میسازند. نوتبوکهایی سفارشیسازی شده به کمک هوش مصنوعی، نقاط شروع اثباتشدهای برای پروژههای جدید ارائه میدهند، در حالی که انطباق هوشمند قالبها، رویکردهای مرتب را بر اساس ویژگیهای پروژه پیشنهاد میکند.
ایجاد مخازن دانش مشترک، یادگیری سازمانی را ثبت کرده و توسعه قابلیتها را سرعت میبخشد. مخازن قابل جستجو از گردشهای کاری موفق، نمونهکدها و تجربیات کسبشده، تیمها را قادر میسازد تا به جای شروع از صفر، بر موفقیتهای قبلی تکیه کنند. انجمنهای متخصصان، امکان اشتراکگذاری تجربیات و رویکردهای حل مسئله فراهم میکنند، در حالی که برنامههای منتورشیپ، کاربران باتجربه را با افراد تازهکار همراه میسازند.
مستندسازی نظاممند از طریق سیستمهای ردیابی آزمایشها تضمین میکند که بینشها ثبت و به اشتراک گذاشته شوند. جلسات بررسی منظم برای بحث درباره نتایج و تجربیات کسبشده، همراه با حلقههای بازخورد که انتخاب ابزارهای آتی را مطلع میسازند، دورههای بهبود مداومی را ایجاد میکنند که قابلیتهای هوش مصنوعی سازمان را در طول زمان ارتقا میدهند.
اقدام ۴: پیادهسازی آموزش جامع سواد داده و هوش مصنوعی
یکپارچهسازی موفق هوش مصنوعی نیازمند برنامههای آموزشی جامعی است که هم مهارتهای فنی و هم مهارتهای تفکر انتقادی را توسعه دهند. سازمانها باید در ارتقای مهارت استعدادهای موجود سرمایهگذاری کرده و در عین حال قابلیتهای جدیدی بسازند که تیمها را قادر سازد از ابزارهای هوش مصنوعی به طور اثربخش و مسئولانه استفاده کنند.
توسعه مهارتهای فنی باید با آموزش تسلط بر ابزار هوش مصنوعی متناسب با کاربران فعلی پایتون و آر آغاز شود. برنامههای عملی که دستیاری هوش مصنوعی را در گردشهای کاری آشنا ادغام میکنند، به تحلیلگران باسابقه کمک میکنند تا تخصص خود را با قابلیتهای ارتقایافته تطبیق دهند. مسیرهای تسلط که کاربران را از دستیاری پایه به اتوماسیون پیشرفته هدایت میکنند، پیشرفتهای یادگیری ساختاریافتهای ارائه میدهند، در حالی که تمرینهای عملی با استفاده از دادههای سازمانی، مرتبط بودن و کاربرد فوری را تضمین مینمایند.
تحلیلگران سنتی نیازمند آموزشهای پل زدن تخصصی هستند که مفاهیم تحلیلی آشنا را به رویکردهای ارتقایافته با هوش مصنوعی پیوند دهد. مسیرهای یادگیری باید تدریجاً و بدون تحمیل بار اضافی به کاربران، دستیاری هوش مصنوعی را معرفی کنند که توسط برنامههای منتورشیپ برای همراهی کاربران باسابقه هوش مصنوعی با تحلیلگران سنتی پشتیبانی میشود. پروژههای تمرینی کمریسک اعتمادبهنفس ایجاد کرده و ارزش عملی را نشان میدهند و پذیرش گستردهتر را در میان تیمهای تحلیلی تشویق میکنند.
آموزشهای پیشرفته برای کاربران حرفهای باید بر مهندسی پرامپت و تکنیکهای بهینهسازی تمرکز داشته باشد تا اثربخشی ابزارهای هوش مصنوعی به حداکثر برسد.
آموزشهای پیشرفته برای کاربران حرفهای بر مهندسی پرامپت و تکنیکهای بهینهسازی تمرکز دارد تا اثربخشی ابزارهای هوش مصنوعی به حداکثر برسد. آموزشهای تخصصی درباره ترکیب چند ابزار هوش مصنوعی برای گردشهای کاری پیچیده، همراه با آموزش درباره محدودیتهای هوش مصنوعی و حالتهای شکست، تضمین میکند که کاربران حرفهای میتوانند حالتهای خاص و مرزهای سیستم را به طور اثربخش مدیریت نمایند.
به همان اندازه، توسعه سواد هوش مصنوعی و قابلیتهای تفکر انتقادی حائز اهمیت است. کاربران باید توانمندیها و محدودیتهای هوش مصنوعی را درک کنند تا انتظارات واقعبینانهای داشته باشند و از اتکای بیش از حد یا عدم بهرهبرداری کافی اجتناب ورزند. آموزشها باید بر تشخیص زمان اتکا به پیشنهادات هوش مصنوعی در برابر رد آنها تمرکز داشته باشند و چارچوبهایی برای ارزیابی کیفیت و مناسب بودن پیشنهادات ارائه دهند.
مهارتهای اعتبارسنجی برای حفظ دقت تحلیلی ضروری میشوند. تیمها نیازمند رویکردهای نظاممند برای تست کدهای تولیدشده توسط هوش مصنوعی و بینشها هستند که اعتبارسنجی آماری را با بررسی منطق کسبوکار ترکیب میکند. ایجاد آگاهی از آگاهی از سوگیری هوش مصنوعی و ملاحظات عدالت، استفاده مسئولانه را تضمین میکند، در حالی که تعیین استانداردهای سازمانی برای کشف و کاهش سوگیری از پیامدهای ناخواستهای که میتوانند نزاهت تحلیلی یا اعتبار سازمان را به مخاطره اندازند، جلوگیری مینماید.
اقدام ۵: استقرار چارچوبهای امنیتی و حکمرانی مستحکم
پیادهسازی قابلیتهای علم دادهِ ارتقایافته با هوش مصنوعی مستلزم چارچوبهای جامع امنیتی و حکمرانی است که از داراییهای سازمان محافظت کرده و در عین حال نوآوری را امکانپذیر سازد. چالش موجود در ایجاد ساختارهایی است که نظارت مناسبی ارائه دهند بدون آنکه آزمایش و چابکی ارائه شده توسط ابزارهای هوش مصنوعی را سرکوب کنند.
ملاحظات امنیتی باید ریسکهای منحصربهفرد مرتبط با خدمات هوش مصنوعی ابری و یکپارچهسازی ابزارهای خارجی را آدرسدهی کند. سیستمهای طبقهبندی دادهها باید سطوح مناسب استفاده از خدمات هوش مصنوعی را تعیین کنند، در حالی که الزامات اقامت دادهها (Data Residency) و تایید انطباق فروشندگان، همراستایی با مقررات را تضمین مینمایند. استانداردهای رمزنگاری برای انتقال و ذخیرهسازی دادهها، همراه با ثبت و پایش جامع دسترسیها، کنترلهای امنیتی بنیادی را فراهم میسازند که از اطلاعات حساس در سراسر گردشهای کاری مجهز به هوش مصنوعی محافظت میکنند.
دستورالعملهای جامع که نوآوری را با مدیریت ریسک متعادل میسازند، گسترش کنترلشده قابلیتهای هوش مصنوعی را تضمین میکنند.
مدیریت امن API برای کنترل دسترسی به خدمات هوش مصنوعی در عین حفظ بهرهوری عملیاتی حیاتی میشود. درگاههای API که دسترسی به خدمات را پایش و کنترل میکنند و با سیستمهای مدیریت هویت سازمان یکپارچه شدهاند، احراز هویت و سطوح دسترسی مناسب را تضمین مینمایند. محدودسازی نرخ درخواست (Rate Limiting) و پایش مصرف از مصرف غیرمجاز جلوگیری میکند، در حالی که گردش کلیدهای API و فرآیندهای پاسخ به حوادث، آسیبپذیریهای امنیتی را برطرف میسازند.
حفاظت از مالکیت معنوی نیازمند بررسی دقیق مدلهای اختصاصی و به اشتراکگذاری دادهها با خدمات هوش مصنوعی است. حمایتهای قراردادی با تامینکنندگان خدمات در مورد استفاده از دادهها و آموزش مدل، همراه با سیاستهای داخلی حاکم بر به اشتراکگذاری الگوریتمهای اختصاصی، به حفظ مزایای رقابتی در عین بهرهمندی از دستیاری هوش مصنوعی کمک میکند.
زیرساخت حکمرانی باید سیاستهای روشنی برای استفاده از ابزارهای هوش مصنوعی در سطوح مختلف طبقهبندی دادهها تدوین کند. دستورالعملهای جامع که نوآوری را با مدیریت ریسک متعادل میسازند، با پشتیبانی گردشهای کاری تایید برای پذیرش ابزارهای جدید، گسترش کنترلشده قابلیتهای هوش مصنوعی را تضمین میکنند. ردپای حسابرسی که دستیاری هوش مصنوعی را در سراسر فرآیندهای تحلیلی ثبت میکند، شفافیت ایجاد کرده و از الزامات انطباق با مقررات پشتیبانی مینماید.
الزامات مستندسازی و قابلیت توضیحپذیری مدل برای حفظ دقت تحلیلی و اعتماد ذینفعان ضروری میشوند. استانداردهای مستندسازی که استفاده از ابزارهای هوش مصنوعی را در توسعه و استقرار ثبت میکنند، همراه با ابزارهای توضیحپذیری و فرآیندهای اعتبارسنجی، تضمین میکنند که مدلهای ارتقایافته با هوش مصنوعی، قابل تفسیر و قابل اعتماد باقی میمانند.
بررسیهای منظم حکمرانی و فرآیندهای پاسخ به حوادث، این چارچوب را کامل میکنند و بهبود مداوم و مدیریت اثربخش چالشهای مرتبط با هوش مصنوعی را با تکامل قابلیتها تضمین مینمایند.
نتیجهگیری
همگرایی هوش مصنوعی با علم داده متنباز نمایانگر فرصتی تحولآفرین برای سازمانها است تا قابلیتهای تحلیلی خود را مقیاسپذیر ساخته و در عین حال پیچیدگی و هزینهها را مدیریت کنند. ابزارهای مجهز به هوش مصنوعی تقابل بنیادی میان مزایای نوآوری متنباز و الزامات عملیاتی سازمانی را حل کرده و امکان مشارکت گستردهتر سازمانی در علم داده را بدون تنزل استانداردهای حرفهای یا کنترلهای حکمرانی میسر میسازند.
برای رهبران فناوری اطلاعات، این تکامل چالشهای مکرری را که سرعت پذیرش هوش مصنوعی را محدود کردهاند برطرف میسازد: شکاف مهارتها، محدودیت منابع، پیچیدگی حکمرانی و دشواریهای یکپارچهسازی. پلتفرمهای مجهز به هوش مصنوعی با خودکارسازی هوشمند کارهای تکراری و در عین حال حفظ اختیارات تصمیمگیری انسانی، قابلیتهای تحلیل پیشرفته را در سراسر سازمان همگانی میسازند و همزمان انعطافپذیری و مزایای هزینهای را که ابزارهای متنباز را جذاب میکند، حفظ مینمایند.
توجیه اقتصادی فراتر از افزایش بهرهوری بوده و تحول راهبردی را شامل میشود. سازمانهایی که علم دادهِ مجهز به هوش مصنوعی را پیادهسازی میکنند میتوانند دسترسی سریعتر به بینشها، بهبود کیفیت مدل از طریق بهترین روشهای خودکار، کاهش ریسک عملیاتی از طریق قابلیتهای ارتقایافته حکمرانی، و افزایش ظرفیت تحلیلی بدون افزایش متناسب در نیاز به استعدادهای تخصصی را انتظار داشته باشند. این مزایا با تسلط بیشتر تیمها بر دستیاری هوش مصنوعی و افزایش بلوغ تحلیلی سازمان، در طول زمان مضاعف میشوند.
مسئله این نیست که آیا هوش مصنوعی علم داده را تحول خواهد داد یا خیر؛ این تحول هماکنون در جریان است.
با این حال، موفقیت نیازمند پیادهسازی نظاممند هدایتشده توسط یک چشمانداز راهبردی روشن است. پنج اقدام کلیدی مطرحشده (ارزیابی تیم و توسعه استراتژی، انتخاب ابزار هوشمند با نظارت انسانی، مدیریت تغییر فرهنگ، برنامههای آموزش جامع، و چارچوبهای حکمرانی مستحکم) رویکردی ساختاریافته برای مدیریت این تحول در عین کاهش ریسکهای اجرایی ارائه میدهند.
پنجره مزیت رقابتی از طریق علم دادهِ مجهز به هوش مصنوعی با آسانتر شدن دسترسی به این قابلیتها و شتابگیری پذیرش آن در صنایع مختلف در حال تنگتر شدن است. سازمانهایی که قاطعانه برای پیادهسازی این فناوریها اقدام میکنند، در حالی که رقبای آنها با محدودیتهای سنتی علم داده دستوپنجه نرم میکنند، قابلیتهای تحلیلی پایهگذاری خواهند کرد که الگوبرداری از آنها روزبهروز دشوارتر خواهد شد.
مسیر پیشرو مستلزم ایجاد تعادل میان نوآوری و مدیریت هوشمندانه ریسک، پذیرش اتوماسیون در عین حفظ تخصص انسانی، و مقیاسپذیری قابلیتها همراه با حفظ استانداردهای کیفیت است. رهبران فناوری اطلاعات که این چالشها را با موفقیت هدایت میکنند، سازمانهای خود را در موقعیتی قرار میدهند که از علم داده به عنوان یک مزیت رقابتی پایدار بهره ببرند، نه یک قابلیت تخصصی و پرهزینه.
مسئله این نیست که آیا هوش مصنوعی علم داده را تحول خواهد داد یا خیر؛ این تحول هماکنون در جریان است. تصمیم حیاتی پیش روی رهبران فناوری اطلاعات این است که آیا این تحول را در سازمان خود رهبری کنند یا پس از آنکه دیگران مزایای تحلیلی را تثبیت کردند، به فشارهای رقابتی واکنش نشان دهند. ابزارها، چارچوبها و استراتژیها امروزه وجود دارند تا این مسیر با موفقیت آغاز شود.
درباره نویسندگان

دونالد فارمر (Donald Farmer) سخنران و نویسنده بینالمللی سرشناس با بیش از ۳۰ سال تجربه در مدیریت داده و تحلیلها است. او به سرمایهگذاران، فروشندگان نرمافزار و سازمانها درباره استراتژی داده و تحلیلها مشاوره میدهد. دونالد تیمهایی را در Microsoft و Qlik رهبری کرده و برخی از مهمترین و نوآورانهترین پلتفرمهای تحلیلی بازار را ساخته است. شرکت مشاوره او، TreeHive Strategy، فرآیندی معروف به Gameplan توسعه داده که سازمانها را قادر میسازد یک استراتژی گامبهگام و اثربخش برای ایجاد فرهنگ تحلیل و سواد داده تدوین کنند. علاوه بر استراتژی داده، دونالد مکرراً در زمینه مسائل حکمرانی و انطباق، به ویژه برای شرکتهایی که معماریهای خودسرویس (Self-service) را پیادهسازی میکنند، مشاوره میدهد. کارگاههای آموزشی او درباره استراتژی نوآوری به ایجاد تحولات چشمگیر در کسبوکارهای متعدد کمک کرده است.

دکتر فرن هالپر (Fern Halper, Ph.D.) نایب رئیس و مدیر ارشد پژوهشهای TDWI در حوزه تحلیلهای پیشرفته است. او در جامعه تحلیل دادهها کاملاً شناختهشده است و در ۲۰ سال گذشته صدها مقاله در زمینه دادهکاوی و فناوری اطلاعات منتشر کرده است. هالپر همچنین همکار نویسنده چند کتاب از مجموعه Dummies در زمینه رایانش ابری و کلانداده است. تمرکز او بر تحلیلهای پیشرفته، از جمله تحلیلهای پیشبینانه، یادگیری ماشین، هوش مصنوعی، رایانش شناختی (Cognitive Computing) و روشهای تحلیل کلانداده است. او شریک شرکت تحلیلگر Hurwitz & Associates و تحلیلگر ارشد داده در Bell Labs بوده است. او در هر دو دانشگاه Colgate و Bentley تدریس کرده و مدرک دکتری خود را از دانشگاه Texas A&M دریافت کرده است.
منبع: posit